
Guides & Références
Vous trouverez ici de l'information sur les principes qui sous-tendent les activités de Genovalia. Cette information est présentée sous forme de guides accompagnés de références. N'hésitez pas à consulter cette section pour en apprendre davantage sur le partage de données. Nous y discutons aussi d'intelligence artificielle, plus spécifiquement de l'apprentissage automatisé et de ses applications.

Ils définissent les bonnes pratiques et normes permettant la réutilisation des données. La signification de l'acronyme est:
F : Facilement trouvable (Findable) - les données doivent être faciles à localiser, tant pour les humains que pour les machines, grâce à des métadonnées détaillées ainsi qu’à des identifiants uniques et pérennes.
A : Accessible (Accessible) - les données doivent pouvoir être récupérées à l’aide de protocoles standardisés, avec des conditions d’accès clairement définies lorsque nécessaire
I : Interopérable (Interoperable) - les données peuvent être intégrées avec d’autres jeux de données et systèmes grâce à l'utilisation de normes et de vocabulaires standardisés
R : Réutilisable (Reusable) - les données sont bien documentées, fiables et leur réutilisation est régie par des licences permettant de les exploiter sans ambiguïté dans de nouveaux contextes
La structuration des données consiste à organiser les données selon un format standardisé, que ce soit au niveau des tableaux, des bases de données ou de leurs champs, afin de permettre leur stockage, leur accès et leur analyse de manière efficace. Dans le cas des jeux de données, la structure principale est le schéma, qui décrit principalement les variables et leurs unités. Un schéma bien documenté permet aux utilisateurs secondaires de mieux comprendre les données et d’éviter les erreurs d’interprétation subséquentes. La structuration des données revêt une importance cruciale lorsqu’il s’agit de rendre des jeux de données publics et de les partager.
La standardisation des données désigne l’utilisation de formats, de définitions et de vocabulaires harmonisés pour organiser et décrire les données, ce qui les rend plus faciles à interpréter, à partager et à réutiliser.
Cela implique généralement :
- des noms de variables cohérents et uniformisés
- des formats et des unités standardisés
- des métadonnées claires
- des vocabulaires contrôlés ou des ontologies
- des règles de codage uniformisées (p. ex. pour les données manquantes)
Les métadonnées sont essentiellement des « données sur les données » qui fournissent des informations contextuelles décrivant et expliquant le contenu d’un jeu de données, facilitant ainsi sa découverte, sa compréhension et sa réutilisation. Dans notre cas, on distingue deux types de métadonnées : 1) les métadonnées descriptives / administratives, et 2) les métadonnées structurelles.
Les métadonnées descriptives visent à répondre à la question : "sur quoi portent les données ?". Elles incluent des informations telles que le titre du jeu de données, les auteurs, les mots-clés associés, ainsi que des informations spatiales ou temporelles (par exemple, où et quand les données ont été collectées). Les métadonnées administratives comprennent des informations sur les personnes ayant créé le jeu de données, son propriétaire, les éventuelles restrictions d’accès ou encore son historique de versions. Ces informations sont synthétisées dans un format DCAT lisible par machine afin d’en améliorer la découvrabilité.
Les métadonnées structurelles documentent l’organisation des données. Elles se matérialisent principalement sous la forme d'un schéma de données, c’est-à-dire une description lisible par machine d’un jeu de données précisant ses variables, étiquettes, types de données, unités, valeurs admissibles, ainsi que toute autre caractéristique nécessaire à son interprétation et à sa réutilisation. Dans le cas d’un jeu de données génomiques, les métadonnées structurelles peuvent inclure des informations détaillées sur les individus génotypés ou séquencés, telles que le genre et l’espèce, les sites d’échantillonnage et les dates de collecte, les détails méthodologiques, les phénotypes et d’autres attributs pertinents. Lorsque possible, des vocabulaires contrôlés ou des termes d’ontologie devraient être utilisés.
La sémantique réfère à la signification des éléments et des termes d’un jeu de données, notamment les variables, les valeurs et leur interprétation. Une sémantique claire améliore grandement la découvrabilité et l’interopérabilité en réduisant l’ambiguïté et en uniformisant les termes employés dans les divers jeux de données.
Une première étape pour améliorer la sémantique consiste à utiliser des vocabulaires contrôlés. Un vocabulaire contrôlé est une liste prédéfinie de termes acceptés, utilisée pour assurer l'uniformité de la nomenclature employée et la cohérence de l’annotation des termes. Bien qu'essentiels, les vocabulaires contrôlés n'offrent généralement peu ou pas de représentation formelle des relations entre les termes, au-delà de simples hiérarchies.
Une ontologie va plus loin en définissant formellement chaque terme ou concept et en précisant explicitement les relations entre eux de manière lisible par machine. Les ontologies fournissent ainsi une description plus complète et structurée d’un jeu de données. Toutefois, elles peuvent également introduire une certaine redondance (c’est-à-dire que plusieurs ontologies peuvent décrire un même concept), ce qui rend essentielle une sélection et une utilisation cohérentes des ressources ontologiques.
Un schéma de données est une description structurée et lisible par machine d’un jeu de données qui définit ses variables ainsi que la manière dont elles doivent être interprétées. Un schéma de données ne se limite pas aux noms des variables : il inclut également leurs définitions, types de données, unités, valeurs admissibles et métadonnées associées, garantissant ainsi que chaque élément du jeu de données possède une signification précise et non ambiguë. En reliant les variables à des termes issus d’ontologies standardisées ou de vocabulaires contrôlés, le schéma apporte une clarté sémantique et favorise l'harmonisation des jeux de données. Cette représentation structurée permet la validation, l’intégration et la transformation automatisées des données, facilitant ainsi l’interopérabilité entre systèmes. Enfin, l’utilisation de schémas de données bien documentés soutient la reproductibilité et améliore donc la qualité des données, contribuant ainsi à les rendre plus facilement trouvables, accessibles, interopérables et réutilisables.
Les PGD sont de plus en plus exigés par les organismes subventionnaires et contribuent à l’excellence de la recherche en améliorant la planification, en réduisant les risques et en renforçant la qualité et l’utilisabilité des données. Ils facilitent également les processus d’approbation éthique et favorisent la collaboration.
Un PGD typique aborde les principaux aspects de la gestion des données, notamment la collecte des données, la documentation et les métadonnées, le stockage et la sauvegarde, la préservation à long terme, le partage et la réutilisation, les rôles et responsabilités, ainsi que la conformité éthique et légale.
Genovalia peut aider à élaborer des PGD personnalisés et à garantir que les données demeurent accessibles, sécurisées et réutilisables.
Au Canada, il existe deux principaux dépôts fédérés. Le premier est Borealis, également connu sous le nom de Dataverse canadien. Le second est le Répertoire fédéré de données de recherche (FRDR), qui est supervisé par l’Alliance de recherche numérique du Canada.
En soutenant les chercheurs dans l'archivage de leurs données dans ces deux principaux dépôts canadiens, Genovalia contribue à donner une seconde vie aux données de recherche. Parallèlement, nous encourageons également les chercheurs à déposer leurs jeux de données sur notre propre plateforme (accessible à l’adresse : https://sedna.apps.genovalia.ulaval.ca/en/catalogue), où nous appliquons des standards plus élevés de structuration et de normalisation des données afin de faciliter davantage leur réutilisation et leur exploration, tant par les propriétaires des données que par la communauté scientifique dans sa globalité.
Bento est une plateforme gratuite et open source de microservices en gestion et en visualisation des données développée par le Centre canadien de génomique computationnelle (C3G) à Montréal (Université McGill). Reposant sur des composants réutilisables et interopérables tels que des API standardisées, Bento favorise les interactions entre les communautés scientifiques mondiales en omique, tout en réduisant la complexité et les coûts liés à la mise en place de portails de diffusion de données. Bento fait ainsi partie intégrante de la Global Alliance for Genomics and Health (GA4GH) et son équipe de développement contribue activement à la gestion des données de la Bibliothèque génomique pancanadienne.
L’émergence du concept « Une seule santé » offre une opportunité unique d’arrimer le catalogue de données de Genovalia, centré sur les données non humaines, à celui de Bento, dédié aux données cliniques et omiques en santé humaine. L’adoption de formats de description des projets et des jeux de données compatibles facilitera la recherche et l’accès à l’information dans les deux catalogues. Cette démarche d’harmonisation s’inscrit dans un projet plus large d’établissement d’une fédération de centres de données interopérables.
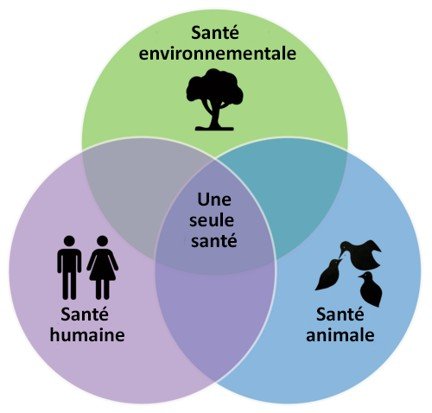
Ratnadass, Alain; Deguine, Jean-Philippe (June 2021). "Crop protection practices and viral zoonotic risks within a One Health framework". Science of the Total Environment. 774 145172. Bibcode:2021ScTEn.77445172R. doi:10.1016/j.scitotenv.2021.145172. ISSN 0048-9697. PMID 33610983. S2CID 231989807
Genovalia utilise deux types d'infrastructures pour entreposer les données. Le premier et le stockage Lustre. Ce type est principalement utilisé lorsque du calcul doit être effectué sur les données.
Le second est le stockage de type CEPH S3.
contenu de la section apprentissage automatisé